การอ่านข้อมูลบนรูปภาพจะไม่ใช่เรื่องยากอีกต่อไป ด้วย AI อัจริยะ ConTextual

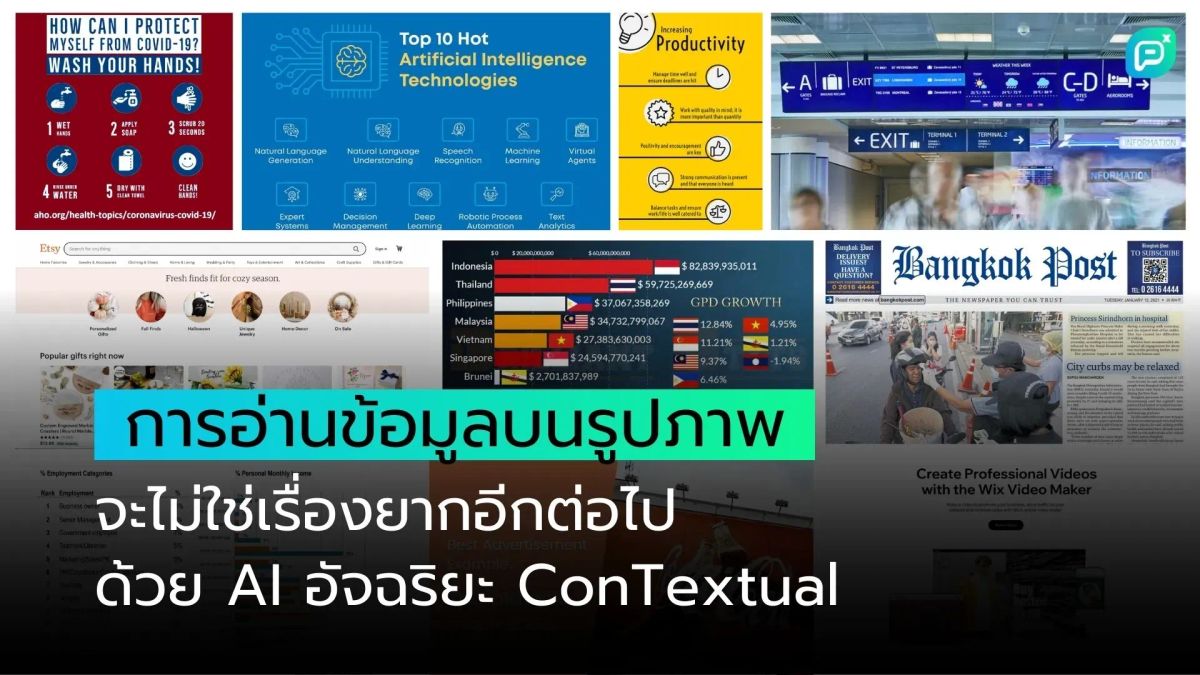
โมเดล AI ใหม่ๆ กำลังพัฒนาความสามารถในการทำความเข้าใจข้อความในรูปภาพได้ดีขึ้นเรื่อยๆ ซึ่งให้ข้อมูลบริบทที่สำคัญ เช่น การนำทางแผนที่ หรือการทำความเข้าใจ meme ความสามารถในการใช้เหตุผลเกี่ยวกับปฏิสัมพันธ์ระหว่างข้อความและบริบทภาพ สามารถขับเคลื่อนแอปพลิเคชันในโลกแห่งความเป็นจริงได้มากมาย เช่น AI assistants หรือเครื่องมือช่วยเหลือผู้พิการทางสายตา
เราเรียกงานเหล่านี้ว่า "Context-Sensitive Text-Rich Visual Reasoning Tasks"
ปัจจุบัน การประเมินผล Large Multimodal Models (LMMs) ที่ผ่านการ fine-tune ด้วย Instruction ส่วนใหญ่ มุ่งเน้นไปที่การทดสอบว่าโมเดลสามารถตอบสนองต่อคำสั่งของมนุษย์ที่อยู่ในรูปแบบของคำถามหรือประโยคคำสั่ง ("นับสิ่งนี้", "แสดงรายการนั้น" ฯลฯ) เหนือภาพได้ดีเพียงใด แต่ไม่ได้ทดสอบว่ามันจะเข้าใจข้อความที่ละเอียดอ่อนต่อบริบทได้ดีเพียงใด
นั่นคือเหตุผลที่เรา (นักวิจัยจาก University of California Los Angeles) ได้สร้าง ConTextual ซึ่งเป็นชุดข้อมูล Context-sensitive Text-rich visual reasoning สำหรับการประเมิน LMMs นอกจากนี้เรายังเปิดตัว Leaderboard เพื่อให้ Community สามารถเห็นด้วยตัวเองว่าโมเดลใดเป็นที่ดีที่สุดสำหรับงานนี้
ConTextual คืออะไร?
ConTextual เป็น Context-sensitive Text-rich visual reasoning dataset ที่ประกอบด้วยชุดคำสั่งที่ท้าทาย 506 ข้อ สำหรับการประเมิน LMM (Large Language Model) เราสร้างชุดคำสั่งที่หลากหลายบนภาพที่เต็มไปด้วยข้อความ โดยมีเงื่อนไขว่าต้องอาศัยการใช้เหตุผลร่วมกันระหว่างข้อความและสัญญาณภาพในรูปภาพอย่างอ่อนไหวต่อบริบท
มันครอบคลุม 8 รูปแบบของภาพในโลกแห่งความเป็นจริง ได้แก่ รูปเวลา การช้อปปิ้ง การนำทาง สิ่งที่เป็นนามธรรม แอปพลิเคชันมือถือ เว็บเพจ อินโฟกราฟิก และรูปภาพเบ็ดเตล็ดทั่วไป
ซึ่งแต่ละประเภทข้างต้นต่างประกอบไปด้วย:
- รูปภาพที่ Text-rich
- คำสั่งที่เขียนโดยมนุษย์ (คำถามหรืองานคำสั่ง)
- คำตอบอ้างอิงที่เขียนโดยมนุษย์
ชุดข้อมูลนี้ถูกเผยแพร่ในสองรูปแบบ:
(a) ชุดตรวจสอบความถูกต้อง (Validation set) จำนวน 100 ตัวอย่างจากชุดข้อมูลทั้งหมด พร้อมคำสั่ง รูปภาพ และคำตอบอ้างอิงสำหรับคำสั่ง
(b) ชุดข้อมูลทดสอบ (Test dataset) ที่มีเฉพาะคำสั่งและรูปภาพเท่านั้น Leaderboard มีผลลัพธ์ของโมเดลทั้งในชุดข้อมูล Validation และ Test ชุดพัฒนา (Development set) ช่วยให้ผู้ปฏิบัติงานสามารถทดสอบและทำซ้ำวิธีการของตนได้อย่างง่ายดาย sandbox สำหรับการประเมินผลมีอยู่ใน github ของเรา
การทดลองประสิทธิภาพของ Large Language Models (LLMs) กับงานด้านวิชวลเอไอ
ในการทดลองเบื้องต้น เราได้ทำการประเมินประสิทธิภาพของ LLMs จำนวน 13 โมเดล โดยแบ่งออกเป็น 3 ประเภทหลักๆ ดังนี้
- Augmented LLM approach: ใช้ GPT4 ร่วมกับข้อมูลภาพในรูปแบบของ OCR และ/หรือ dense image captions
- Closed-Source LMMs: ได้แก่ GPT4V(ision) และ Gemini-Vision-Pro
- Open-Source LMMs: ประกอบด้วย LLaVA-v1.5-13B, ShareGPT4V-7B, Instruct-Blip-Vicuna-7B, mPlugOwl-v2-7B, Bliva-Vicuna-7B, Qwen-VL-7B และ Idefics-9B
ชุดข้อมูลของเรามี Reference response สำหรับแต่ละ Instruction ซึ่งช่วยให้เราสามารถทดสอบวิธีการประเมินอัตโนมัติได้หลากหลาย ในการประเมินผล เราใช้วิธี LLM-as-a-judge โดยป้อน instruction, reference response และ predicted response เข้าไปใน GPT-4 ซึ่งโมเดลจะต้องตอบกลับมาว่า predicted response นั้นยอมรับได้หรือไม่ (เราเลือกใช้ GPT4 เนื่องจากมันมีการตัดสินใจที่ใกล้เคียงมนุษย์มากที่สุด)
มาดูตัวอย่างกันบ้าง
ตัวอย่างที่ 1: ในกรณีนี้ GPT-4V ให้คำตอบที่ไม่ถูกต้องต่อ Instruction แม้ว่าจะมีการใช้เหตุผลที่สมเหตุสมผลก็ตาม การใช้สีเขียวแสดงถึงคำตอบที่ตรงกับ Reference ในขณะที่สีแดงเน้นข้อผิดพลาดในคำตอบ นอกจากนี้ยังมีการสรุปเหตุผล (Summarized Reasoning) เพื่ออธิบายหลักการที่ GPT-4V ใช้ในการหาคำตอบ
ตัวอย่างที่ 2: ในตัวอย่างนี้ GPT-4V ตอบคำถามได้ถูกต้องตาม Instruction แต่ ShareGPT-4V-7B (open-source LMM ที่ทำงานได้ดีที่สุด) และ GPT-4 w/ Layout-aware OCR + Caption (Augmented LLM) กลับให้คำตอบที่ผิด เนื่องจากขาดการใช้เหตุผลร่วมกันระหว่างข้อความ
ข้อสรุปสำคัญ
ในระหว่างการทำงานนี้ เราพบว่า:
- LMMs (Language Model for Dialogue Applications) ยุคใหม่ทั้งแบบ proprietary และ open models มีปัญหาในการทำงานกับชุดข้อมูล ConTextual ในขณะที่มนุษย์ทำได้ดี ซึ่งบ่งชี้ถึงความเป็นไปได้ในการปรับปรุงโมเดลเพื่อเพิ่มประสิทธิภาพการใช้เหตุผลกับรูปภาพที่มีข้อความมาก ซึ่งเป็น domain ที่มีการประยุกต์ใช้งานจริงอย่างมาก
- LMMs แบบ proprietary มีประสิทธิภาพต่ำในการใช้เหตุผลกับ infographics ที่เกี่ยวข้องกับการอ่านเวลา ซึ่งบ่งชี้ถึงช่องว่างในความสามารถเมื่อเทียบกับมนุษย์ โดยเฉพาะอย่างยิ่ง GPT-4V ซึ่งเป็นโมเดลที่ทำงานได้ดีที่สุด มีประสิทธิภาพเหนือกว่ามนุษย์ในการใช้เหตุผลเชิงนามธรรม ซึ่งอาจเป็นเพราะการเปิดรับข้อมูล memes และ quotes แต่มีปัญหาในงานที่เกี่ยวข้องกับเวลาซึ่งมนุษย์ถนัด
- สำหรับ Open-Source Models อย่าง LLaVA-1.5-13B และ ShareGPT-4V-7B พบว่ามีช่องว่างที่ชัดเจนระหว่าง Domains ที่ได้รับการยอมรับจากมนุษย์ในระดับที่ยอมรับได้ (บริบทนามธรรมและบริบทจิปาถะทั่วไป) กับ Domains อื่นๆ (การอ่านเวลา, Infographics, Navigation, Shopping, Web และ Mobile Usage) ดังนั้นจึงเป็นไปได้ว่า Domains จำนวนมากที่เราครอบคลุมในตัวอย่างของเราอยู่นอกเหนือการกระจายข้อมูลสำหรับ Models เหล่านี้ ดังนั้น Open-Source Models ควรมุ่งเน้นไปที่การเพิ่มความหลากหลายใน Training Data ของพวกเขา
- การเสริม LMMs ด้วย Large Language Model ซึ่งรับข้อมูลภาพที่ถูกแปลงเป็นข้อความผ่าน OCR หรือ Captions นั้นทำได้ไม่ดีนัก โดยมีอัตราการอนุมัติจากมนุษย์เพียง 17.2% ตัวอย่างของเราต้องการทั้งการรับรู้ภาพที่แม่นยำและการจัดตำแหน่ง Vision-Language Alignment ที่ละเอียดอ่อนเพื่อแก้ปัญหา
ผลการวิเคราะห์ของเราชี้ให้เห็นถึงแนวทางที่น่าสนใจในการพัฒนาต่อยอดดังนี้:
- การพัฒนา image encoders ที่มีประสิทธิภาพสูงขึ้น เพื่อเพิ่มความแม่นยำในการแปลงข้อมูลภาพเป็น latent representation
- การสร้างคำอธิบายภาพ (image descriptions) ที่มีความถูกต้องแม่นยำสูง เพื่อให้ AI สามารถเข้าใจเนื้อหาในภาพได้ดียิ่งขึ้น
- การทำ fine-grained vision-language alignment เพื่อปรับปรุงการรับรู้ (perception) ของ model และลดการเกิด hallucinations หรือการสร้างเนื้อหาที่ผิดพลาดจากการเข้าใจผิด
สิ่งเหล่านี้จะนำไปสู่ความสามารถในการใช้เหตุผลทางภาพ (visual reasoning) ที่มีประสิทธิภาพมากขึ้น โดยอาศัยบริบท (context) และข้อมูลตัวอักษร (text) ที่อยู่ในภาพร่วมด้วย
ข้อมูลอ้างอิงจาก: Introducing ConTextual: How well can your Multimodal model jointly reason over text and image in text-rich scenes?